Lucene 2.10索引文件:
Term:项。为分词后最小单位,具体和使用的分析器有关,Lucene内置为单字。
Field:域。相当于数据库表的字段。
Document:文档。域信息的集合。
Segment:段。一个完整定1索引。
|
文件名称
|
后缀名称
|
说明
|
|
segments_N
|
|
段,表示一个完整独立的索引;N为36进制数
|
|
segments
|
.gen
|
segments辅助文件,主要用来生成计数
|
|
SegmentName
|
.fnm
|
域集合信息文件
|
|
SegmentName
|
.fdt
|
域值信息文件
|
|
SegmentName
|
.tis
|
项信息文件
|
|
SegmentName
|
.tii
|
项信息索引文件
|
|
SegmentName
|
.frq
|
项频数文件
|
|
SegmentName
|
.prx
|
项位置信息文件
|
|
SegmentName
|
nrm
|
标准化因子文件
|
|
SegmentName
|
.tvx
|
文档信息索引文件
|
|
SegmentName
|
.tvd
|
文档信息文件
|
|
SegmentName
|
..tvf
|
每个域项向量信息文件
|
|
备注
|
SegmentName为_N,N为36进制数
|
一.
Lucene原始存储数据类型(Primitive Types)
|
类型名称
|
说明
|
|
Byte
|
8 byte
|
|
UInt32
|
32 byte四字节无符号整型,高位优先
|
|
UInt64
|
64byte八字节无符号整型,高位优先
|
|
VInt
|
可变长度整型。0-127单字节,128-16383两字节,类推
|
|
Chars
|
UNICODE字符串
|
|
String
|
写入格式为:VInt,Chars,字符串长度加字符串
|
二. Lucene索引文件
1. Segments
文件名称:segments_N,N为36进制数。
说明:在一个索引目录中,至少存在一个Segments文件,但可索引活动的只会有一个:N值最大的。其他的Segments文件可能为临时文件,一般情况是索引修改进程没有完成。
格式:Format,Version,NameCounter,SegCount,<SegName,SegSize,DelGen,HasSingleNormFile,NumField,NormGenNumField,IsCompoundFile>SegCount
Format,NameCounter,SegCount,SegCount,SegSize,NumField:UInt32
Version,DelGen,NormGen:UInt64
SegName:String
IsCompound,HasSingleNormFile:Byte
格式说明:Format = SegmentInfos.FORMAT_SINGLE_NORM_FILE = -2;Version当前时间与UTC时间的差值的毫秒数,每次对索引进行修改时会变化;SegName是所有索引生成文件的前缀;SegSize是当前Segment中包含的Document的数量;
示例:
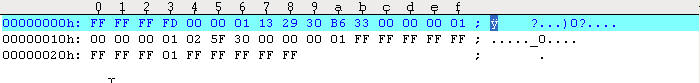
FF FF FF FD:FOMAT = -2,UInt32
00 00 01 13 29 30 B6 33:Version = 1181807064627,UInt64
00 00 00 01:NameCount = 1,UInt32
00 00 00 01:SegmentCount = 1,UInt32
02:SegmentNamePrefixLength = 2,VInt
5F 30:SegmentName = “_0”,Chars
00 00 00 01:SegSize = 1,UInt32
FF FF FF FF FF FF FF FF:DelGen = -1,UInt64
01:HasSingleNormFile = 1,Byte
FF FF FF FF:NumField = -1,UInt32
FF:IsCompoundFile = -1,Byte
在2.1版本中还会生成segment.gen文件,主要保存了索引计数,格式为:Version(SegmentInfos.LOCKLESS = -2),Generation,Generation。
示例:

FF FF FF FE:Version = -2,UInt32
00 00 00 00 00 00 00 02:Generation = 2,UInt64
00 00 00 00 00 00 00 02:Generation = 2,UInt64
2. Field Info
文件名称:SegmentName.fnm。
说明:保存了所有Field的名称。
格式:FieldCount,<FieldName,FieldBits>FieldCount
FieldCount:VInt
FieldName:String
FieldBits:Byte
格式说明:
示例:

01:FieldCount = 1,VInt
04:FieldNamePrefixLength = 4,VInt
49 6E 66 6F:FieldName = “Info”,Chars
01:Bits = 1,Byte
3. Stored Field Index
文件名称:SegmentName.fdx
说明:保存了每个Document的Field Data的地址指针
格式:<FieldValuesPosition>SegSize
FieldValuesPosition:UInt64
格式说明:
示例:

00 00 00 00 00 00 00 00:FieldValuesPosition = 0,UInt64
4. Stroed Field Data
文件名称:SegmentName.fdt
说明:保存了每个Document的需要存储的Field数据。
格式:<DocFieldData>SegSize
DocFieldData:FieldCount,<FieldNum,Bits,Value>FieldCount
FieldCount:VInt
FieldNum:Vint
Bits:Byte
Value:String | BinaryValue(取决于Bits)
BinaryValue:ValueSize,<Byte>^ValueSize
ValueSize:VInt
格式说明:
示例:

01:FieldCount = 1,VInt
00:FieldNum = 0,VInt
01:Bits = 1,Byte
17:FieldValuePrefixLength = 23,VInt
49 20 77 72 69 74 65 20 61 20 6C 65 74 74 65 72 20 6C 65 74 74 65 72:Value = “I write a letter letter”,Chars
5. Term Info Index
文件名称:SegmentName.tii
说明:保存了所有Term Inofs(.its)文件的索引间隔条目。
格式:TIVersion,IndexTermCount,IndexInterval,SkipIntervala,MaxSkipLevels,TermIndices
TIVersion:UInt32
IndexTermCount:UInt64
IndexInterval:UInt32
SkipInterval:UInt32
TermIndeices:<TermInfo,IndexDelta>IndexTermCount
IndexDelta:VInt
格式说明:
示例:

FF FF FF FE:TIVersion = -2,UInt32
00 00 00 00 00 00 00 01:TermCount = 1,UInt64
00 00 00 08:IndexInterval = 128,UInt32
00 00 00 10:SkipInterval = 16,UInt32
00:MaxSkipLevels = 0,Byte
6. Term Infos
文件名称:SegmentName.tis
说明:存储了所有Term的信息。
格式:TIVersion,IndexTermCount,IndexInterval,SkipIntervala,MaxSkipLevels,TIVersion:UInt32
IndexTermCount:UInt64
IndexInterval:UInt32
SkipInterval:UInt32
MaxSkipLevels:VInt
TermInfos:<Term,DocFreq,FreqDelta,ProxDelta,SkipDelta>TermCount
Term:<PriefixLength,Suffix,FieldNum>
格式说明:Term按照字典顺序排序;Term的内容是可以共享的。例如:上一个Term为“bone”,当前Term为“boy”,则当前的Temr的PrefixLength为2,Suffix为“y”。
示例:
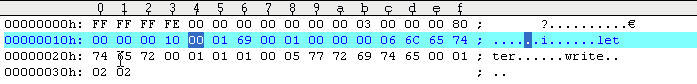
FF FF FF FE:TIVersion = -2,UInt32
00 00 00 00 00 00 00 01:TermCount = 1,UInt64
00 00 00 08:IndexInterval = 128,UInt32
00 00 00 10:SkipInterval = 16,UInt32
00:MaxSkipLevels = 0,Byte
01:TermTextPrefixLength = 1,VInt
69:TermText = “i”,Chars
00:FieldNumber = 0,VInt
01:DocFreq = 1,VInt
00:FreqDelta = 0,VInt
00:ProxDelta = 0,VInt
00:SkipDelta = 0,Vint
以下Term类似
7:Frequencies File
文件名称:SegmentName.frq
说明:
格式:
格式说明:
示例:

8. Positions File
文件名称:SegmentName.prx
说明:保存了每个Term在Document中的位置集合。
格式:
格式说明:
示例:

9.TermVectors Iindex File
文件名称:SegmentName.tvx
说明:保存了在.tvd中的文档数据的指针。
格式:TVXVersion,<DocumentPosition>NumDocs
TVXVersion:UInt32
DcoumentPosition:UInt64
格式说明:
示例:

00 00 00 02:TVXVersion = 2,UInt32
00 00 00 00 00 00 00 04:DocumentPosition = 4,UInt64
10.Term Vectors Document
文件名称:SegmentName.tvd
说明:
格式:TVDVersion,<NumFields,FieldNums,FieldPositions>NumDocs
TVDVersion:UInt32
NumFields:VInt
FieldNums:<FieldNumDelta >NumFields
FieldPosition:VInt
格式说明:
示例:

00 00 00 02:TVDVersion = 2,UInt32
01:NumFields = 1,VInt
00:FieldNumDelta = 0,VInt
04:FieldPosition = 4,VInt
11.Term Vectors Field
文件名称:SegmentName.tvf
说明:
格式:TVFVersion,<NumTerms,Position/Offset,TermFreqs>NumFields
TVFVersion:UInt32
NumTerms:VInt
Position/Offset:Byte
TermFreqs:<TermText,TermFreq,Positions/Offsets>NumTerms
TermText:<PrefixLength,Suffix>
PrefixLength:VInt
Suffix:Chars
TermFreq:VInt
Position:<VInt>TermFreq
Offsets:<VInt,VInt>TermFreq
格式说明:
示例:

00 00 00 02:TVFVersion = 2,UInt32
03:NumTerms = 3,VInt
00:
00:
01:TermTextPrefixLength = 1,VInt
69:TermText = “i”,Chars
01:TermFreq = 1,VInt
00:Position/Offset = 0,VInt
06:TermTextPrefixLength = 6,VInt
6C 65 74 74 65 72:TextText = “letter”,VInt
02:TermFreq = 2,VInt
00:Position/Offset = 0,VInt
05:TermTextPrefixlength = 5,VInt
77 72 69 74 65:TermText = “write”,Chars
01:Position/Offset = 1,VInt
12.Compound File
文件名称:SegmentName.cfs
说明:当采用复合文件建立索引时,所有索引文件会保存在一个.cfs文件内。
格式:FileCount,<DataOffset,FileName>FielCount,FileDataFielCount
FielCount:VInt
DataOffset:UInt64
FileName:String
FielData:文件原始数据(raw file data)
格式说明:
示例:

0B:FileCount = 8,VInt
00 00 00 00 00 00 00 A6:DataOffset = 166,UInt64
06:FileNamePrefixLength = 6,VInt
5F 30 2E 66 6E 6D:FileName = “_0.fnm”,Chars
根据文件数据偏移量(DataOffset) 166,可以知道字段信息文件(Field Info)“_0.fnm”的数据存储起始位置在167处。其他文件类
posted on 2007-06-14 14:45
Terry Liang 阅读(2566)
评论(3) 编辑 收藏 所属分类:
Lucene 2.1研究